개요#
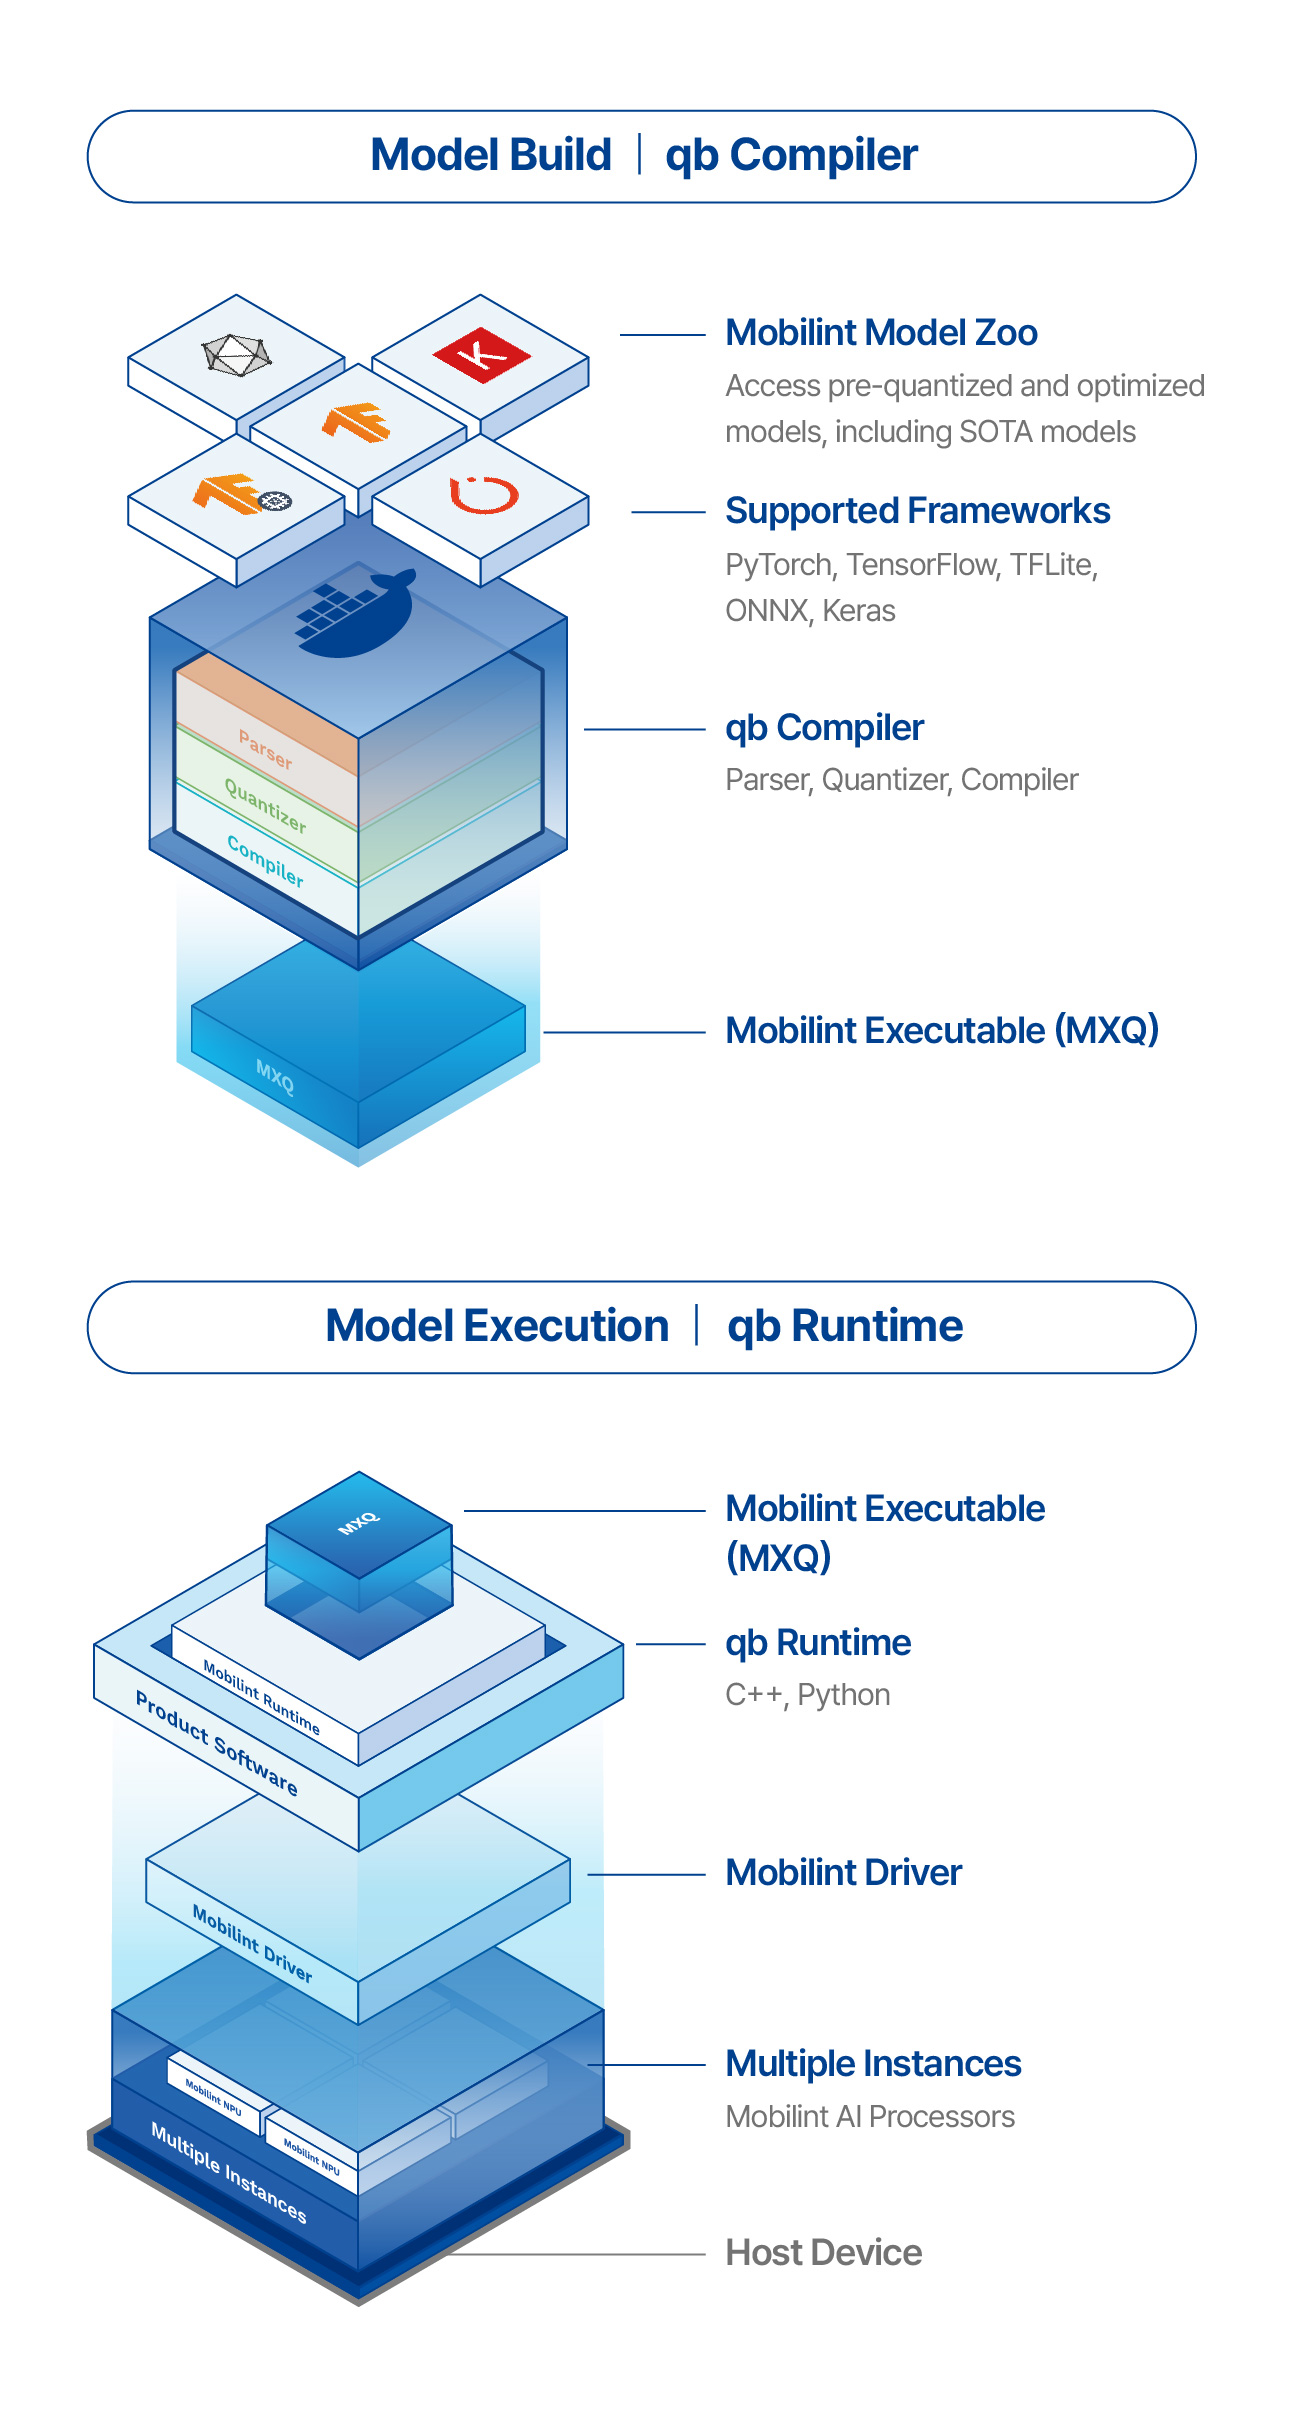
qb Compiler는 학습이 완료된 딥러닝 모델을 모빌린트 NPU에서 실행할 수 있는 MXQ 형식으로 변환합니다. 입력 모델은 ONNX, PyTorch, HuggingFace transformers, TensorFlow, TFLite 등 다양한 형식을 지원합니다.
이 매뉴얼은 다음 모델 변환 흐름을 기준으로 구성되어 있습니다.
원본 모델 -> MBLT -> MXQ
MBLT는 모빌린트의 파싱된 모델 형식입니다. qb Compiler가 원본 프레임워크 형식을 읽은 뒤의 모델 그래프와 가중치를 담습니다. MXQ는 특정 모빌린트 target device에 배포할 수 있도록 MBLT에서 생성되는 산출물입니다.
qb Compiler란?#
qb Compiler는 호스트에서 학습되거나 내보낸 모델을 모빌린트 런타임 환경에서 사용할 수 있도록 준비합니다. 일반적인 입력은 다음과 같습니다.
내보낸 원본 모델 파일 또는 PyTorch 모델 객체
입력 형상, PyTorch 계열 모델의
feed_dict같은 모델 입력 정보실제 배포 환경을 대표하는 캘리브레이션 데이터
target device 문자열
선택적인 컴파일 설정 또는 프리셋
주요 출력은 .mxq 파일입니다. 단계를 나누어 실행하는 작업 흐름에서는 .mblt 파일도 생성할 수 있으며, 이 파일을 사용해 MXQ 생성 전에 모델의 추론 그래프 표현을 확인할 수 있습니다.
원본 모델 -> MBLT -> MXQ#
파이프라인은 두 개의 개념적 단계로 나눌 수 있습니다.
첫 번째로 parse는 원본 모델을 MBLT로 변환합니다.
ONNX / PyTorch / HuggingFace transformers / TensorFlow / TFLite -> MBLT
두 번째로 quantize는 MBLT를 MXQ로 변환합니다.
MBLT -> MXQ
quantize라는 명령 이름은 캘리브레이션만 의미하지 않습니다. 이 매뉴얼에서 quantize는 MBLT에서 MXQ를 만드는 전체 단계이며, 캘리브레이션, 양자화
결정, target device별 컴파일, 런타임에 필요한 machine-instruction 패키지 생성을 포함합니다.
일반적인 경우에는 compile을 사용하여 두 단계를 한 번에 실행합니다.
원본 모델 -> MBLT -> MXQ
모델과 target device가 이미 정해져 있다면 엔드투엔드 compile을 사용합니다. 다음과 같은 경우에는 parse와 quantize를 나누어 사용하고 중간 MBLT 파일을 별도로 저장합니다.
MBLT를 Netron에서 시각화
지원하지 않는 레이어 디버깅
파싱된 모델 재사용
같은 MBLT에서 여러 양자화/설정 선택지 비교
지원 입력 형식#
qb Compiler는 다음 공개 백엔드를 지원합니다.
onnx: ONNX 모델torch: PyTorch 모델 및 HuggingFace/transformers 흐름torchscript: TorchScript 모델tf: TensorFlow 및 Keras로부터 저장된 모델tflite: TensorFlow Lite 모델
새 컴파일 작업 흐름에는 ONNX와 PyTorch 입력 형식을 권장합니다. TensorFlow, TFLite, TorchScript는 해당 형식이 이미 모델 내보내기 경로나 배포 작업 흐름에 포함되어 있을 때 사용합니다.
HuggingFace LLM 컴파일은 별도 백엔드가 아니라 backend="torch" 작업 흐름으로 설명합니다. 컴파일러는 별도의 HuggingFace 백엔드 대신
PyTorch/transformers 모델 경로나 객체를 입력으로 받습니다.
지원 모빌린트 NPU 디바이스#
target device 문자열은 컴파일 대상 target device를 선택합니다. CLI와 Python API에는 다음 값 중 하나를 정확히 지정합니다.
NPU 칩 |
target device 문자열 |
|---|---|
|
|
|
|
ARIES와 REGULUS는 NPU 칩 이름입니다. aries-rb, regulus-ra, regulus-rb, regulus-rb-usb는 CLI와 Python API에 전달하는 target device 문자열입니다. API에는 NPU 칩 이름만 쓰지 말고 정확한 target device 값을 사용합니다.
주요 산출물#
자주 사용하는 산출물은 다음과 같습니다.
.mxq: 선택한 target device 배포용 산출물.mblt: 파싱된 모델 그래프와 가중치, 검사 및 단계별 컴파일에 사용캘리브레이션 데이터 디렉터리: MXQ 생성 중 사용하는 전처리된 샘플 텐서
캘리브레이션 메타데이터
.txt: 캘리브레이션 도우미가 생성한 샘플 경로 목록컴파일 설정
.json또는.yaml: CLI 또는 Python 작업 흐름에서 사용하는 선택적 설정